YuE2 官方只说"与 Suno v5/v6 有竞争力":真正的增量是那张能改的谱,不是屠榜
开源音乐模型 YuE2 的技术报告与官方仓库都摊在桌面上:官方口径是「competitive with Suno v5/v6」、best-of-8 的 SongBench 均分 6.9632、单候选 6.73 超过所有已评测公开基线、专家盲听对 Suno v5 接近持平(49.3% vs 34.6% 是符号规划本身的偏好度)。转述把它们写成"狂飙逆袭屠榜",还把许可证说成 CC BY-NC 4.0——实际是代码 Apache-2.0 加一份单独的 MODEL_LICENSE,明确把"免费学术用途"和"个人产出变现"分开。真正被低估的能力有三个:可读写可编辑的符号层、同一 checkpoint 的零样本翻唱、以及让外部语言模型改歌的 agentic editing。
综述
一篇流传很广的公众号文章把开源 AI 音乐模型 YuE2 写成"一夜变天""狂飙逆袭 Suno",并给出两组数字:人类盲听竞技场 MusicArena 上「全球第 4,ELO 1197,把 Suno V5.5(第 5,1187)压在身下」;WildSongBench 上 best-of-8 得分 6.9632,超过 Suno v5 的 6.8721、v5.5 的 6.7150、v6 的 6.5562;许可证是「CC BY-NC 4.0 非商业」。
一手材料出来后,这几件事得分别摆正。
YuE2 的技术报告在 arXiv 上的编号是 2609.33757(eess.AS,提交于 2026-09-27,56 页,标题 YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality,35 位作者),官方仓库是 github.com/multimodal-art-projection/YuE,权重挂在 m-a-p/YuE2-3B。仓库首页我们当场读到:12.1k star、1.4k fork、106 watcher、190 commits、最近一次提交是 2026-10-06——所以"1.1 万 star"这个说法没问题,是转述里少数站得住的数字。
README 的原话是:「YuE2 is competitive with Suno v5/v6 on WildSongBench. YuE2 (best-of-8) achieves 6.9632 SongBench Avg, the highest observed mean among all evaluated settings.」 注意它用的是 competitive with,不是 beat、不是 crush。而论文摘要的措辞更收敛:「Expert listening further establishes its competitiveness with proprietary song generators, favoring best-of-8 over Suno v4.5 and yielding nearly balanced preferences against Suno v5.」——对 Suno v4.5 占优,对 Suno v5 近乎持平。
至于「MusicArena 全球第 4 / ELO 1197 / Suno V5.5 第 5 / 1187」这组数:官方 README 里确实挂着一个 Music Arena 入口,而且是团队自己在跑的公开盲听投票("YuE2 needs your ears……Hear anonymous clips and choose A, B, or a tie. No account needed"),但这份榜单上当前的名次与 Elo 分值我们没有当场核到;同一张表里被拿来对比的 "Suno v5.5" 也没有找到对应出处。这篇文章把这三组数字按可信度分了三档,因为后面所有判断都要靠它们站得住。
专业分析
一、6.96 和 6.73 是两件事,混着说就成了"屠榜"
论文与 README 给的是同一张 WildSongBench(192 条提示词,中英语料,基准集在 m-a-p/WildSongBench)上的两个设定:
| 设定 | SongBench 均分 | 官方怎么描述它 |
|---|---|---|
| 单候选(一次生成,不挑) | 6.73 | 「exceeding all evaluated public baselines」——超过所有已评测的公开基线 |
| best-of-8(生成 8 首选 1) | 6.9632 | 「the highest observed mean among all evaluated settings」——所有被评测设定里观测到的最高均值 |
两个措辞的差别非常讲究,也最容易被抹平。6.73 那句的边界是"公开基线",意思是把范围限定在开源可复现的那一批里它第一;6.96 那句的边界是"设定(settings)",best-of-8 本身是一个花了 8 倍算力的抽样策略,把它和别人的单次生成放同一列比,就是转述文章里"把商业巨头按在地上打"的来路。
有意思的是,转述文章反过来写"如果只看点一次生成的常规模式,YuE2 均分约 6.73,与商业旗舰同一战壕"——这句其实比"屠榜"那段准确得多,只是它被放在了标题的对立面。所以正确的一句话是:单次生成,它赢了所有公开对手,和 Suno 打平手;八次挑一首,它是目前这张表上的最高分。
同一个表里还有一个数字值得一提,因为转述文章完全没提:Mureka 9 是 6.9377。也就是说 best-of-8 的 YuE2 领先第二名不到 0.03 分。这个差距在任何主观评分量表上都属于噪声级别,把它讲成"按在地上打"需要额外的勇气。
二、真正被低估的不是分数,是那张能改的谱
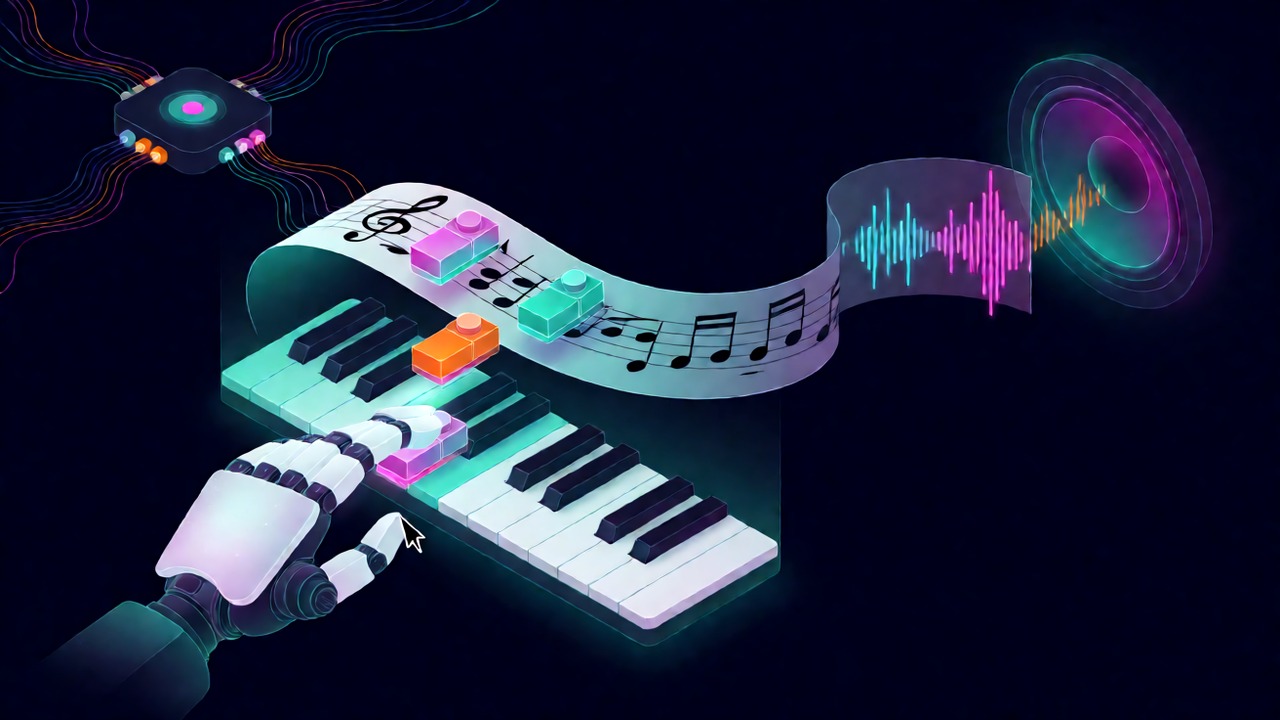
技术报告的核心主张其实是架构层的,摘要第一句就把问题点出来了:符号模型能把旋律、和声、节奏、曲式写明白,但通常到不了成品录音;音频模型能出完整歌曲,但作曲过程是隐式的。 YuE2 要做的是用一个 AR-NAR Mixture-of-Transformers 骨干把两端打通:先写出一份可读的谱(旋律与和声),展开成语义音乐 token,再实现成带人声与伴奏的完整音频。
这条路线带来三个能力,都是"抽卡式"音频模型给不了的:
- 白盒可控。 README 的说法是「Read, play, and change the composition before rendering it. Melody and chords become explicit controls that a person or an agent can inspect and edit.」——渲染之前就能读、能弹、能改,旋律与和弦成了显式控件。
- 同一个 checkpoint 做零样本翻唱与改歌。「Reimagine a transcribed song in a new style, or refine a song through a conversation about its score, arrangement, and lyrics—all with the same generation checkpoint.」不用针对翻唱单独训练。
- agentic music editing。 谱是可读文本,所以外部语言模型能把"副歌那段钢琴太吵"这句反馈翻译成对乐曲的修改。这才是 AI 音乐工作流里第一次出现"可以对话式微调的对象"——过去你面对的是一个 mp3,改不了,只能重摇。
同一 checkpoint 内还有硬数据支持这条路线的价值:在相同权重的前提下做对照,专家对"有符号规划"的整体偏好是 49.3%,"无规划直出"是 34.6%;并且统一模型比"语言模型 + 扩散 Transformer 分开做"更受偏好。这个 49.3/34.6 是方法内部的消融对比,不是对 Suno 的胜负比——转述文章把它放在"碾压"的语境里,属于张冠李戴。
支撑这套路线的还有两个配套模型:MERT2(语义监督,报告称在 15 项 MARBLE 指标中的 14 项创下新 SOTA)与 SheetSage2(把录音反推成谱,用于翻唱与乐谱编辑,报告称在 15 组基准-指标对中领先 12 组)。它们的意义是让"没有对齐乐谱的录音"也能拿来学作曲——符号监督的瓶颈被转录模型补上了。
顺带一提,仓库里有个 skills/yue2-music 目录:2026-09-25 起,这个 agent skill 能把一句描述、一份 ABC 谱或一段参考录音变成器乐作品,默认由 YuE2 写谱。音乐生成第一次以"给 agent 装的技能"形态发布,这和站内 Archify 把仓库画成架构图的技能 是同一种分发方式的变化——模型厂商开始把入口做成 skill,而不是做成网页。
三、许可证:不是 CC BY-NC,而是"代码 Apache + 权重单独一份"
这是整件事上被讲错得最实在的一块,而且错得很有代表性。
仓库文件列表里躺着两份许可:LICENSE,提交说明写着「License YuE2 repository code and skill under Apache 2.0」(2026-09-10);以及 MODEL_LICENSE,提交说明写着「Separate free academic use from individual output monetization」(2026-09-16),同一批改动还更新了 THIRD_PARTY_NOTICES.md。
这三行提交信息本身就把政策结构说清楚了:
- 代码与 skill 走 Apache-2.0——工程上可以随便集成、改、发。
- 权重另有 MODEL_LICENSE,不等同于 Apache。
- 而且它专门做了一次切分:"免费学术用途"与"个人把自己产出变现"分开处理。这意味着转述文章那句"个人独立创作者卖自己生成的歌没问题,但想包装成商用 App 赚钱必须另外获取授权",方向是对的;但"CC BY-NC 4.0"这个定性是错的——CC BY-NC 是一刀切禁止所有商业用途的许可证,跟"个人产出变现被单独允许"正好相反。
为什么这种错会大面积出现?因为 Hugging Face 的模型卡有一个 license 元数据字段,抓取工具和摘要站点都读它。元数据写 apache-2.0,于是"全 Apache";转述者知道不该信元数据,去查了个"最严格"的说法填上,于是"CC BY-NC"。两种答案都来自不看 LICENSE 文件正文。 一份模型的真实许可状态,今天需要读至少三个地方:仓库 LICENSE、仓库 MODEL_LICENSE(或等价文件)、模型卡正文里的许可证段落,元数据字段只作辅助。
对照站内同一周的另一篇:Qwen-Image-2.1 把许可证从 Apache 2.0 换成仅限研究的版本。两条线放一起看,2026 年 9 月这个月的开源生成模型有了一个共同结构:权重公开可得,但"能不能拿它赚钱"被单独写成一条,各家给的答案还不一样——YuE2 允许个人变现、对企业部署设条件;Qwen 图像线默认只给研究与评估、商用要邮件谈;音频/视频侧走 API 收口。选模型时,许可证是第 0 个 benchmark。
需要给这句话设个边界:我们核到了两份许可文件的存在与它们的适用范围表述,没有逐条复核 MODEL_LICENSE 全文的具体条款清单(例如企业部署的门槛、衍生命名的要求)。真要投产,请以仓库文件正文为准,别以本文为准。
四、开源侧的算力叙事,同样需要打折
转述里最有感染力的两段是"周末深夜本地跑出一首华尔兹"和「开发者 Ivan Fioravanti 在 M5 Max 上 100% 本地离线跑通 YuE2-3B,还有开发者用 MLX 在 M2 Ultra 上几分钟导出完整曲目」。
一手材料能确认的是:这是一个 3B 级的开源权重模型,官方主张「frontier song quality」,社区报道普遍描述它能在一块 24GB 显存的消费级 GPU 上生成约 5 分钟完整歌曲;官方 README 挂了「Try online (free)」的在线入口。
不能确认的是:Apple Silicon 上的 MLX 移植、M5 Max 全离线运行、M2 Ultra 数分钟导出这几条,我们没有找到可核对的一手记录。 这不是说它们一定假——本地跑通本身门槛不高,移植完全可能存在——只是它们目前的证据等级是"推文与转述",而"苦于闭源平台限制的创作者们倍感振奋"这类结论,是建在这些推文上的。
同样需要打折的还有"3.58B 参数"这个数:模型名与 HF 仓库都是 YuE2-3B,我们在摘要与首页没有读到明确标注的总参数量。写 3B 级是稳的,写 3.58B 需要一个来源。
还有一点容易被忽略:best-of-8 这个"最强数字"的算力代价是 8 次生成。当本地跑通被当作卖点时,抽卡策略的成本不会消失,只是从订阅费变成了你自己的显存和时间。这与 Volcengine 把语音编辑做成"说错一个字不用重录" 是两个方向的同一件事:能不能局部修改,决定了你为一首歌/一条口播付多少次生成的钱。
五、它自己也在推盲听,这件事值得单独说
YuE2 团队没有只放分和报告,README 顶部挂着一个公开盲听投票入口,规则是听匿名片段、选 A/B/平局、无需账号、建议戴耳机。这个设计有两个后果。
一是评测的可争议性被主动交给了社区:谁都能进去投,样本量随时间变,名次会漂。转述引用的"ELO 1197 第 4 名"如果是某个时刻的快照,那它天然过期得快,不该出现在一篇讲"格局已定"的文章标题里。
二是它和站内 Kandinsky 让声音画面一起长出来、Vidu Q4 把价格打到一秒 9 分钱 那条线撞在了一起:音视频生成模型的竞争指标,正在从"厂商自评的分数"迁移到"公开可参与的偏好投票 + 单位成本"。对使用者来说这是好消息(榜单不再只由发布方掌握),对厂商是坏消息(一次刷分换不来长期位置)。
关联信息与影响
站内相关:Qwen-Image-2.1 的许可证转向与 2GB 显存边缘部署(同一时期、同一类结构变化,一硬一软两份许可文本对照);火山引擎语音编辑模型("可局部修改"在语音侧的等价物);Kandinsky / Vidu Q4 视频生成两连发(音视频同赛道的评价体系迁移);Archify 交互式架构图技能(模型以 skill 形态分发)。
对谁有用:做音乐工具的团队——YuE2 的代码是 Apache,可以现在就开始评估工程集成,但产品化前必须读 MODEL_LICENSE 并确认自己那类用法落在哪一档;独立创作者——"个人产出变现"被单独切出来这件事,比"开源"两个字更有实际意义;做技术媒体与内容转述的人——这篇里的三处错(把 competitive 写成碾压、把消融偏好度 49.3/34.6 当成对 Suno 的胜负、把 MODEL_LICENSE 说成 CC BY-NC)都不是恶意编造,全是不读一手文件的结果,而这三处错一旦进了标题就会被互相抄。
未来展望
三个可验证的后续。第一,官方公开盲听的实际结果,与论文里"对 Suno v5 近乎持平"是否一致——这能判断团队自评的乐观程度。第二,MERT2 / SheetSage2 的转录质量是否会成为下一个瓶颈:符号路线的一切优势都建立在"谱写得对"上面,谱错了,可编辑性反而会把错误固定下来。第三,报告承认的短板(摘要里没写、但仓库与评测轴里能看到的方向)能否在下一版解决:音素错误率(PER)在 WildSongBench 里作为代理指标存在,本身说明咬字稳定性仍是需要单独量化的问题,而中文与生僻字上的发音漂移是这类模型最难啃的工程活。
信号强度
7.9 / 10
- 技术主张硬度 9/10:符号规划统一 AR-NAR、可读可编辑乐谱、同 checkpoint 零样本翻唱与 agentic editing、消融偏好 49.3% vs 34.6%——全部来自技术报告摘要原文,且方向明确(改的是生成范式,不只是刷分)。
- 榜单证据硬度 6/10:6.73 / 6.9632 与"competitive with Suno v5/v6"为官方口径,可直接引用;但 MusicArena 的名次与 Elo 分值我们未能当场核实,"Suno v5.5"是否存在也没有依据,转述里的 6.7150 / 6.5562 两行请以官方表格为准,本文不作背书。
- 许可合规价值 9/10:
LICENSE与MODEL_LICENSE双文件结构、以及"个人产出变现单独处理"这一条,是本周最实用的可执行信息,同时也纠正了一个流传很广的错误定性。 - 扣分项:3B 级模型的具体总参数量、Apple Silicon 本地运行的可复现性、MODEL_LICENSE 全文条款清单,这三项我们都留了口子没有做实;Mureka 9 的 6.9377 与 YuE2 的差距小到不足以支撑任何"碾压"叙事,这一点我们只在文中提示、未做独立盲听复验。
本站直读 arXiv 2609.33757 摘要页与 GitHub 仓库首页(星数、license 文件、README 原话);WildSongBench 分项表未逐条复核
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://github.com/multimodal-art-projection/YuE(GitHub)