12GB 笔记本跑 27B:本地 Agent 的胜负手,已经从显存变成了 KV 管理
一个 13 stars 的新仓库,把 Qwen3.8-27B 塞进了 12GB 显存的笔记本:256K 上下文不是全长稠密注意力,而是靠 KVMem 选页。实测 200K 首次预填充 424 秒,但重复请求只需 112 毫秒。
综述
10 月 15 日,GitHub 上出现了一个名叫 qwen3.8-27b-ninfer-5070tilaptop-kvmem-local-agent 的仓库。名字很长,信息也很直白:在 RTX 5070 Ti Laptop 的 12GB 显存上,跑 Qwen3.8-27B,做本地 Agent。
它基于 NInfer-all、NInfer 与沈三殊的 KVMem,仓库里明确感谢了 B 站 UP 主 0xFFFF7。项目采用 Apache-2.0,10 月 16 日最后推送。截至 10 月 19 日,只有 13 stars、0 forks——这是一个非常小的个人项目,不是大厂背书的基础设施。
但它的实测数据值得看一眼:200K 输入首次预填充 424.62 秒,完全重复的请求只需 112 毫秒;64K 上下文下三任务六工具续接 396–679 毫秒;加权 decode 84.11 tok/s。这组数字解释了一个正在发生的变化:本地大模型的瓶颈,正在从「显存装不装得下权重」转向「KV 缓存怎么管」。
专业分析
一、256K 是逻辑容量,不是稠密注意力
先把最容易误解的地方说清楚:这个方案宣称的 256K 上下文,不等于模型对 256K token 做全长稠密注意力。KVMem 的做法是只选择部分页面参与注意力计算,256K 是逻辑上的上下文容量,实际注意力和显存占用由选页策略控制。
这两者的差别很大。全长稠密注意力下,KV 缓存随上下文线性增长,27B 模型在 12GB 显存上根本不可能跑到 200K。选页式 KV 管理把「记住多少」和「每次算多少」解耦,才让长上下文在消费级显卡上变得可行。
代价是:被选中的页面之外,信息可能被漏掉。所以这类方案的核心指标不是「支持多长」,而是「在该召回的时候能不能召回」。
二、实测数字:预填充很贵,复用很便宜
维护者给出的数据里,最有信息量的是冷启动与热复用的巨大落差:
| 场景 | 实测结果 |
|---|---|
| 200K 首次预填充 | 424.62 秒 |
| 完全重复请求 | 112 毫秒 |
| 64K 三任务六工具续接 | 396–679 毫秒 |
| 加权 decode | 84.11 tok/s |
| 49K 工具续接 TTFT | 约 248 毫秒 |
| 49K 冷输入 TTFT | 约 61.5 秒 |
| 固定短文 decode | 67.50 tok/s |
| 代码生成 decode | 84.61 tok/s |
| GPU 峰值占用 | 约 11,124 MiB |
这组数字说明了一个很实际的工程结论:长上下文本地 Agent 的体验,取决于缓存命中率,而不是模型标称速度。 第一次把 20 万 token 塞进去要等七分钟,但只要会话不换、前缀不变,后续工具调用就是几百毫秒级。对「一个项目连续干几小时」的 Agent 工作流,这个 trade-off 是成立的;对「每次问一句新问题」的聊天场景,则完全不成立。
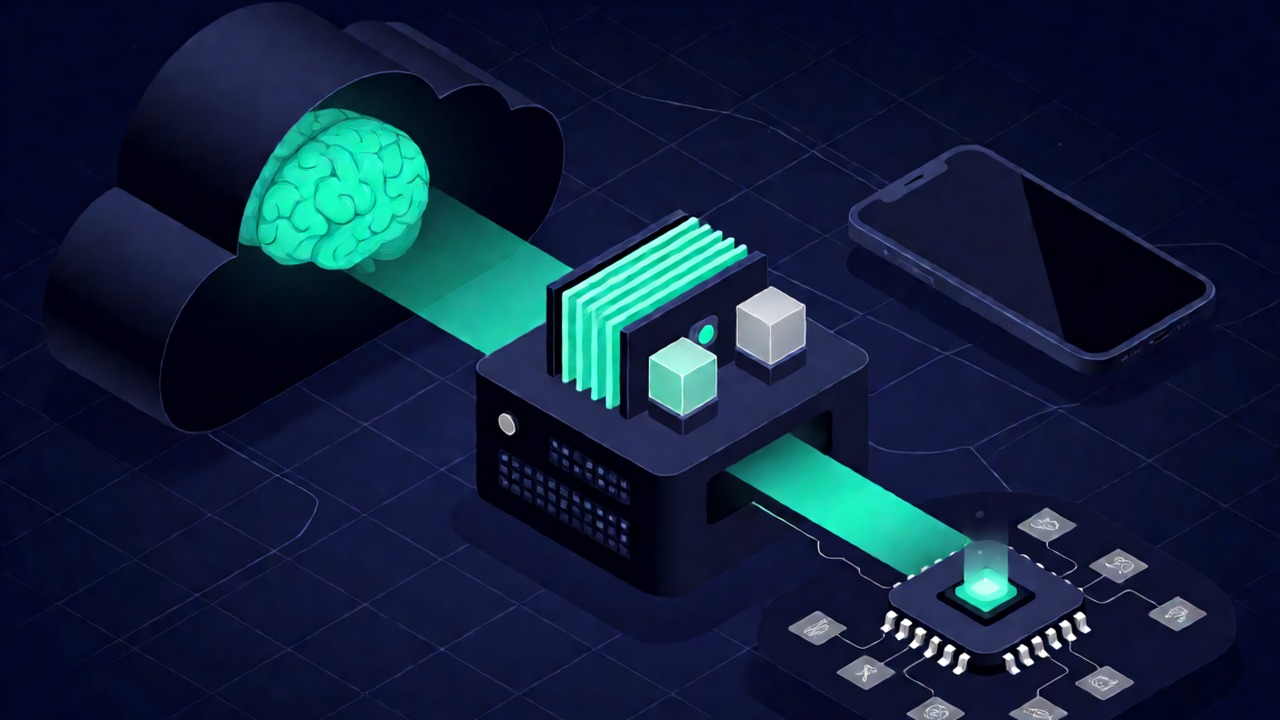
仓库还给出 7 GiB Host KV 的配置。这不是显存溢出,而是引擎主动管理的 RAM 缓存,用来把暂时不参与注意力的 KV 页面放在主机内存里。换句话说,它把显存当成了「热页缓存」,把内存当成了「冷页仓库」。
三、v0.1.1 的工具续接:只算新增的 52 个 token
更贴近 Agent 场景的一组数据来自 v0.1.1:62K 输入、累计生成 43,775 tokens、发生工具调用、三轮续接。工具结果回来之后,系统只对新产生的 52 个 token 重新计算,首 token 延迟 915 毫秒,后续三轮 382–411 毫秒。
这正是 KV 复用对 Agent 的意义。Agent 的典型负载不是「一问一答」,而是「长前缀 + 短增量」:系统提示、项目文件、历史工具结果基本不变,每轮只追加一小段。如果每轮都重算前缀,再强的显卡也扛不住;如果前缀缓存能稳定命中,消费级硬件就能跑出可交互的体验。
风险与口径说明
这个项目必须带着几个限定条件看。
第一,样本极小。13 stars、0 forks、创建于 10 月 15 日,意味着它还没有经过社区独立复现。文中的数据主要来自维护者自述,本站未做独立验证。
第二,测试覆盖有限。维护者验证了 128K / 200K 的合成召回、生成历史与工具续接,但没有跑满 256K 的整模型压力测试。128K 召回 5/5、200K 召回 4/5(6144 KV 档位)说明选页策略在长上下文下已经开始丢信息,200K 时 5 次里漏 1 次,对严谨任务是不能忽略的失败率。
第三,硬件与驱动强绑定。12GB 显存下 CUDA 启动余量约 84MiB(维护者进阶档 39168 / 6144),这种级别的余量意味着换驱动、换量化、换上下文长度都可能直接 OOM。它不是开箱即用的产品,更像一份可复现的实验记录。
第四,decode 速度不等于端到端速度。84 tok/s 是在特定短输出、特定档位下的结果;长上下文预填充的几百秒才是用户真正感知到的等待。
关联信息与影响
这条线索与近期端侧小模型的热潮看似相反,其实互补:一条路是把模型做小(2B、4B),另一条路是把大模型的 KV 管好,让 27B 在 12GB 上也能跑。前者牺牲参数换确定性,后者牺牲部分注意力换容量。
对本地 Agent 来说,这意味着硬件门槛的叙事要改。过去大家问「我的显卡能不能装下 27B」,现在更该问「我的显存能不能放下热 KV 页,内存够不够做冷页仓库,我的工作流有没有稳定的长前缀」。
未来展望
短期,这类方案会在「项目级长会话」场景先落地:代码库问答、文档审阅、持续跟踪型 Agent。它们的共同点是前缀稳定、增量小、对首次延迟容忍度高。
中期,KV 选页策略会成为独立的研究与工程赛道。谁能在 200K 上下文下把召回率从 4/5 提到 5/5,同时保持几百毫秒的续接延迟,谁就掌握了本地长上下文的关键。
长期,本地 Agent 的硬件选型会从「显存越大越好」转向「显存 + 内存 + 缓存策略」的综合配置。12GB 笔记本跑 27B 现在还是一个脆弱的实验,但它指出的方向——把 KV 当成分层缓存来管理——大概率是对的。
对各类群体的影响
- 本地部署玩家:多了一条 12GB 跑 27B 的实验路径,但需要接受极高的调参成本和 OOM 风险。
- Agent 开发者:应把「前缀稳定性」当成架构指标,减少系统提示与历史的重排,才能吃到 KV 复用红利。
- 硬件厂商:显存之外,主机内存容量与带宽会重新影响本地推理的可用性。
- 企业 IT:这类方案目前不适合作为生产基础设施,但适合做隐私敏感场景的原型验证。
- 研究者:KV 选页的召回率与延迟 trade-off,是一个可量化、可复现的研究问题。
CSUNX233 开源 12GB 笔记本本地 Agent 方案,Qwen3.8-27B + NInfer + KVMem,200K 预填充 424.62 秒、重复请求 112 毫秒
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://github.com/CSUNX233/qwen3.8-27b-ninfer-5070tilaptop-kvmem-local-agent(GitHub)