云端大脑,端侧小脑:从 120B 到 2B,Agent 的部署边界正在重画
同一周,NVIDIA 拿出 120B 开源多模态与 24GB 可跑的 74B-A9B,面壁把 MiniCPM-V 4.7 压到 1B 并让 35B-A3B 在手机上跑。本机 Ollama 实测 2B 级模型约 30 tok/s,工具调用一次命中。
综述
10 月 15 日,NVIDIA 发布 Nemotron 3.5 系列;几乎同一时间,面壁智能与 OpenBMB 放出 MiniCPM-V 4.7。两条消息放在一起看,端侧模型的叙事已经变了:不再只是「把大模型压小、看看能不能跑」,而是开始回答「哪些活可以彻底离开云端」。
NVIDIA 这边的产品线拉得很开:120B 的 Nemotron 3.5 Super VL 走开源多模态旗舰路线;74B-A9B 的 Bolt 用原生 2-bit 量化,宣称 24GB 内存就能本地跑;4GB 的 Bolt E4B 面向 RTX、Jetson 与 DGX Spark,但要到 10 月 23 日才推出,截至本文成稿尚未可用。
面壁这边则是另一端:MiniCPM-V 4.7 同时提供 1B 与 35B-A3B 两个版本,Apache-2.0 开源,1B 版官方称在总分与推理效率上明显超过 Qwen3.5 0.8B;35B-A3B 则宣称是首个能在端侧流畅运行的开源 MoE,在 iPhone 17 Pro Max 上占用 3GB 内存、跑到 13+ tok/s。
专业分析
一、120B 开源多模态:把「前沿准确率」做成可下载权重
Nemotron 3.5 Super VL 是一个 120B 参数的开源多模态模型,官方称其在同类中速度最快,最高可达 5 倍吞吐;用约五分之一的参数量达到前沿级准确率,重点面向 OCR、表格、图表与 PDF 理解。
训练侧的数字也公开了:约 26T tokens 预训练,后训练约 380 万样本加强化学习,权重、数据集与训练配方一起开放。这个组合的意义不在于又一个榜单分数,而在于多模态文档理解第一次有了可审计的开源基线——企业可以自己验证它在发票、报表、扫描件上的表现,而不是只接受厂商演示。
当然,「同口径最快」「五分之一参数」都是官方口径,需要第三方在相同硬件、相同精度下复测。120B 也不是端侧模型,它更像云端大脑的开放版本。
二、24GB 跑 74B-A9B:量化把「本地」的边界推到工作站
真正让本地部署群体兴奋的是 Nemotron 3.5 Bolt 74B-A9B。A9B 意味着总参数 74B、每 token 激活约 9B,再加上原生 2-bit 量化,官方称 24GB 内存即可运行,并已支持 llama.cpp、Ollama、LM Studio、Unsloth 与 vLLM。
这里的工程含义值得展开。MoE 的显存瓶颈主要来自「总参数要装下」,而不是「每 token 都算一遍」;2-bit 量化进一步把权重体积压到原来的四分之一左右。两者叠加,才让 74B 级模型落进单机 24GB 的范围。官方称其在 PinchBench 上位列同类开源第一、BrowseComp 第二,但这两个成绩同样需要独立复现。
更需要注意的是质量代价。2-bit 量化对知识密集、长链推理任务的损伤通常大于对格式化和工具调用任务的损伤。它适合做本地 Agent 的「执行脑」,不适合无条件替代云端强模型做最终判断。
三、1B 与 35B-A3B:端侧的两条极端路线
MiniCPM-V 4.7 的 1B 版本走的是「极小多模态」路线:采用 LLaVA-UHD v4 的 intra-ViT 早期压缩,支持 4x/16x 混合视觉 token 压缩,把图像 token 数量压下来,再交给小语言模型。官方称其在总分与推理效率上明显超过 Qwen3.5 0.8B。
35B-A3B 版本则相反:总参数 35B、激活 3B,官方称是首个能在端侧流畅运行的开源 MoE,在 iPhone 17 Pro Max 上以 3GB 内存跑到 13+ tok/s。这个数字如果成立,说明「手机跑 35B 级 MoE」已经从演示进入了可用区间,但 3GB 内存口径需要看清是权重占用、峰值占用还是系统分配,不能直接等同于「一台 3GB 内存的手机就能跑」。
生态适配是这次更实在的进步:iOS、Android、HarmonyOS 三端,Rockchip、Houmo、Intel、AMD、Arm 等芯片平台,SGLang、vLLM、llama.cpp、Ollama 等推理框架,以及 GGUF、BNB、AWQ、GPTQ、FP8 等量化格式。模型能不能用,往往不取决于参数,而取决于这条工具链是否齐全。
本机实测:Ollama 里的 MiniCPM5-2B
为了给「端侧到底能不能干活」一个体感,我在本机 Ollama 上跑了一轮测试。先说明型号:本机安装的是 openbmb/minicpm5-2b:latest,这是一个 2.5B 级文本/工具模型,不是这次发布的 MiniCPM-V 4.7 多模态模型。它的 capabilities 为 tools / thinking / completion,没有 vision,因此下面的结果不能用来评价 MiniCPM-V 4.7 的视觉能力。
测试环境:
| 项目 | 配置 |
|---|---|
| CPU | Intel Core Ultra 7 255H |
| GPU | Intel Arc 140T,16GB |
| 内存 | 31.4GB |
| 模型 | MiniCPM5-2B,Q4_K_M,GGUF,约 1.56GB |
| 上下文 | 标称 131,072,实际运行 4,096 |
| 运行方式 | llama.cpp runner,size_vram: 0,纯 CPU/内存 |
实测结果:
| 场景 | 输出/耗时 | 速度 |
|---|---|---|
| 开启 thinking,180 tokens | 6.04 秒 | 约 29.8 tok/s |
| 关闭 thinking,70 tokens | 2.249 秒 | 约 31.1 tok/s |
| 工具调用(get_weather) | 16 tokens / 0.485 秒 | 一次命中 |
关闭 thinking 的那次,首 token 前有 43 个 prompt token,其中 26 个命中缓存,加载只花了 0.014 秒。工具调用给的是 get_weather,问题是「北京现在天气怎么样?请调用工具查询」,模型输出:
{"name":"get_weather","arguments":{"city":"Beijing"}}content 为空,参数正确。这说明 2B 级模型在「单工具、明确指令」的场景已经可以稳定工作。它跑在纯 CPU 上,没有吃到 Arc 核显,仍有约 30 tok/s——对本地助手、离线工具调用、隐私敏感的小任务,这个速度是够用的。
但要克制地解读:这是一次单点测试,不是系统评测;4,096 的实际上下文远低于标称的 131,072;复杂多工具编排、长文档理解、中文参数保真度都还没有覆盖。2B 能干活,不等于 2B 能独立撑起通用 Agent。
口径与边界
这一波发布里有三处容易写错的地方。
第一,Nemotron 3.5 Bolt E4B 计划 10 月 23 日推出,截至 10 月 19 日还不能下载。把它写成「已上线」是事实错误。
第二,MiniCPM-V 4.7 的 1B 与 35B-A3B 是两个不同模型,不能把 35B-A3B 的手机成绩安到 1B 头上,也不能把 1B 的「超过 Qwen3.5 0.8B」推广到整个系列。
第三,本机测的是 MiniCPM5-2B,不是 MiniCPM-V 4.7-1B。两者同属面壁/OpenBMB 的小模型产品线,但一个偏文本与工具,一个偏多模态,能力边界不同。
关联信息与影响
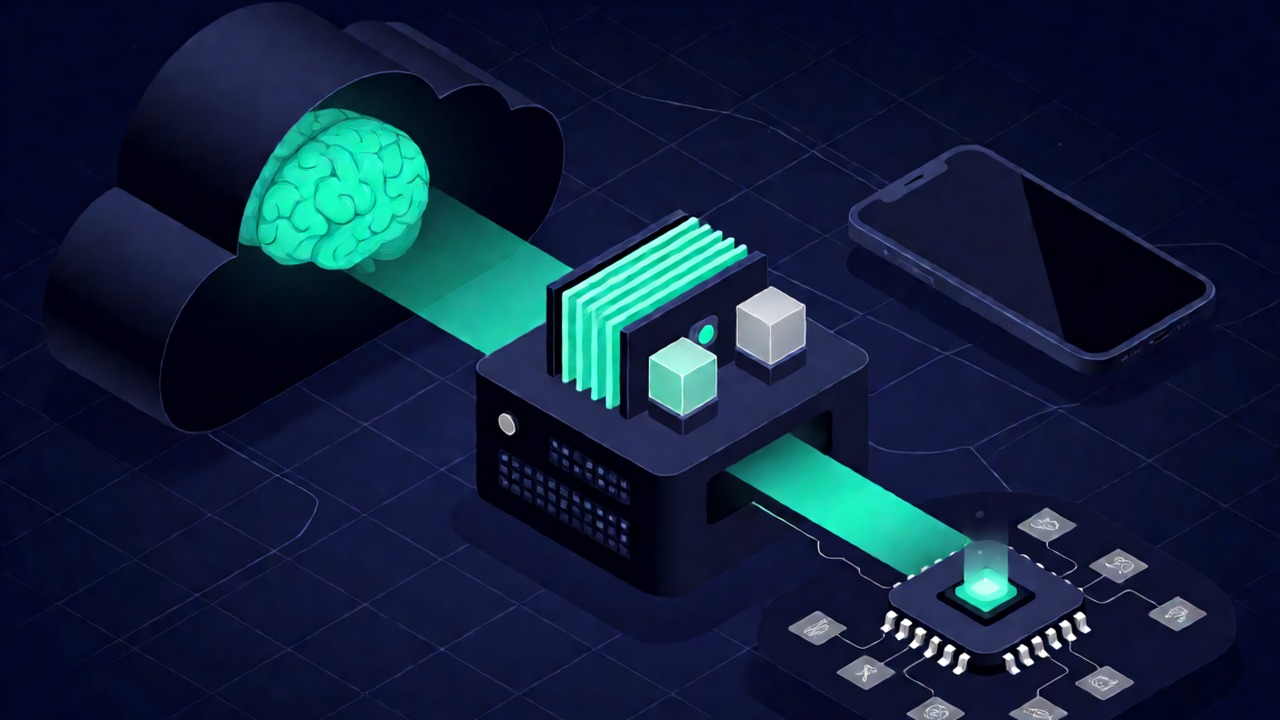
把这一周放进更大的图景:云端在往「更大、更全模态、更开放权重」走,端侧在往「更小、更专用、更完整工具链」走。中间层则是 24GB 级工作站能跑的 74B-A9B。三条路线不是替代关系,而是同一个 Agent 系统的三层部署结构——云端做规划与难题,工作站做批量执行,手机与 PC 做即时、隐私敏感的本地任务。
对开发者来说,选型标准应该从「参数量」转向「任务闭环」:这个模型能不能稳定调用工具、能不能在目标硬件上保持可接受的首 token 延迟、量化后是否还保得住关键能力。
未来展望
短期,1B-4B 级模型会先吃掉离线助手、端侧 OCR、简单工具调用等场景;24GB 级的 74B-A9B 会在工作站上承担「本地执行脑」;120B 级开源多模态则成为企业自建文档理解管线的基线。
中期,端侧竞争的关键不再是「能不能跑」,而是「跑完之后能不能被信任」:量化后的能力衰减、长上下文召回、工具调用的参数保真、跨端一致性,都会成为硬指标。
长期,Agent 的部署形态大概率是分层的:云端大脑负责不确定性强的高价值判断,端侧小脑负责高频、低延迟、隐私敏感的日常动作。真正的分水岭不是模型多大,而是任务能不能在本地闭环。
对各类群体的影响
- 开发者:Ollama 等工具链已把端侧门槛降到「一条命令」,但型号、量化与上下文配置必须逐项核对。
- 企业 IT:24GB 工作站跑 74B-A9B 让「本地执行脑」变得可行,仍需评估 2-bit 量化的质量损失。
- 手机与 PC 厂商:35B-A3B 这类端侧 MoE 会成为新卖点,内存口径与真实峰值占用需要透明化。
- 研究者:开源权重、数据集与配方齐备,适合做多模态文档理解的可复现基线。
- 内容创作者:本地 2B 模型已能承担素材整理与工具调用,但成稿质量仍需人工把关。
Nemotron 3.5 Super VL 与 MiniCPM-V 4.7 同周发布,端侧模型从「能跑」进入「能干活」;本机 Ollama 实测 MiniCPM5-2B 约 30 tok/s
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://blogs.nvidia.com/blog/nemotron-3-5-super-vl/(NVIDIA 博客)