火山引擎语音编辑模型:口播说错一个字,不用重录了
视频剪完才发现口播说错一个词?火山引擎发布语音内容编辑模型:用自然语言说"把 A 改成 B",模型负责自然地改,保留原声音色和语气。口播纠错、广告改词、配音调整不用再整条重录。
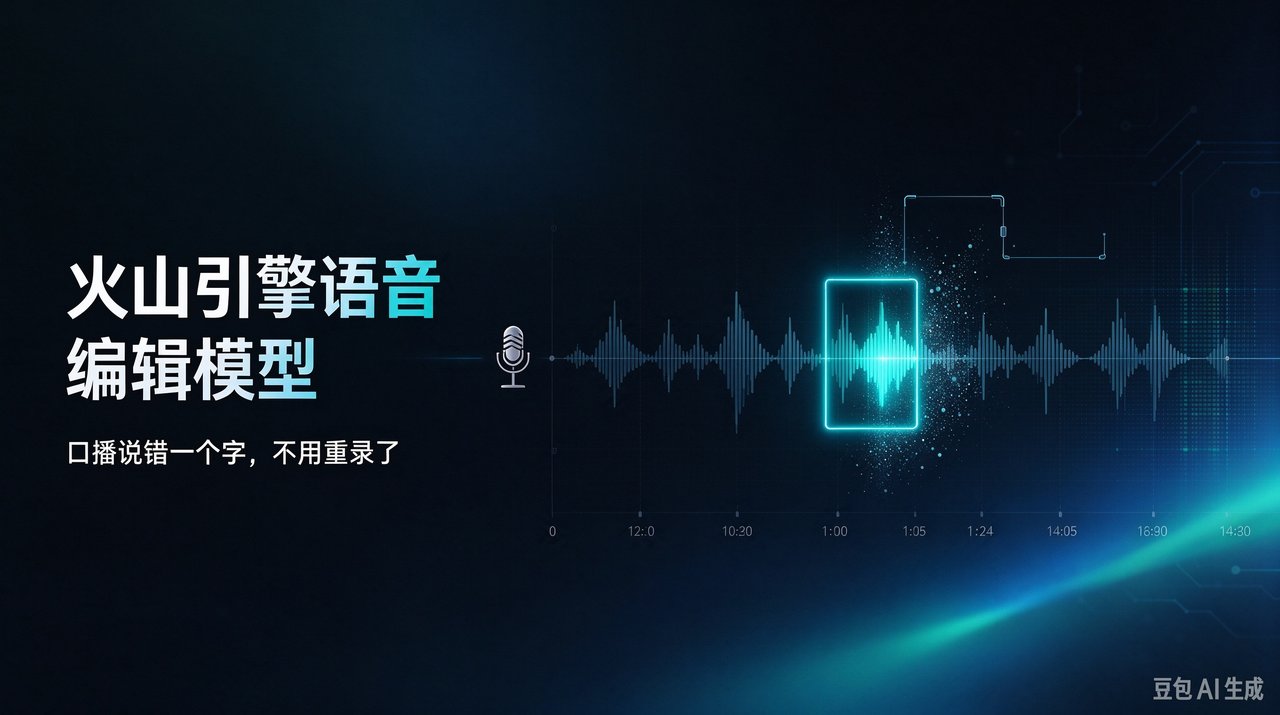
火山引擎语音编辑模型:口播说错一个字,不用重录了
做视频的人都有过这种绝望时刻:一段视频拍好了、剪辑了、配乐了、字幕都对完了,最后检查发现口播里有一个词说错了。
重录?要重新找状态、重新进棚、重新对齐画面。补录?要处理音色差异、语气断层、前后衔接。为改几个字,牵动整条内容生产链路——这是内容创作者最熟悉的高血压瞬间。
火山引擎多媒体实验室发布的语音内容编辑模型,把这件事变轻了:你用自然语言指令说"要改什么",把"怎么自然地改进原声音"交给模型。
三个转变
这个模型代表的是语音编辑的一次范式转移:
- 从"修音质"到"改内容":不只处理噪声、混响,而是能改正语音里真实说出的信息
- 从"重录"到"局部再生成":不为一个词返工整条视频,定位问题片段、生成自然替换
- 从"专业后期"到"自然语言指令":不用懂复杂音频工具,只说"把 A 改成 B"
官方给的例子很直白:"把'败血症'改成'坏血病'""把'极速款'改成'极速版'"——就是这种一句话的事。
难点在"保留人味"
语音编辑真正难的地方,不是把新台词"念出来",而是让它听起来仍然像原来那个人、在原来那段语境里自然说出来。模型的做法是:同时理解原声音频和修改意图,利用原音频的上下文信息,尽量延续说话人的音色、韵律和表达方式,优化目标四个词:内容正确、音色保持、韵律自然、衔接顺滑。
技术上,模型先把声音转成音频 Token,结合自然语言指令做"语义先行"的规划(先想清楚怎么改,再生成声音),解码时引入原音频的声学特征和说话人特征作参考——所以改出来的片段,是"那个人"在"那个语境"里说的话,不是一段陌生的合成音。
怎么用:一句话的事
面向口播纠错、产品信息修订、广告素材改词、配音微调和存量视频再编辑。用法就是:对模型说"把什么改成什么",剩下的交给它——不用拆解流程、不用理解音频参数。
信号强度
这个模型补上的,是内容生产链路里"语音内容可编辑"这一环:音质可以增强(Adobe)、声线可以迁移(ElevenLabs)、现在语音里的具体内容也可以精准编辑——三件套齐了。对创作者,这等于给"口播失误"上了保险:不用再为一个词赌上整条片子的交付时间。
对做视频、做口播、做广告和配音的人,这是一条值得关注的进展:"说错了就重录"的时代正在过去——以后改口播,会像改文档里的一个错别字一样简单。
原载:InfoQ
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://www.infoq.cn/article/07qzHLvyNXSW1SFNV5NV(InfoQ)