大模型跑在奇怪的地方:PS5、iPhone、迷你 PC 的本地推理新活法
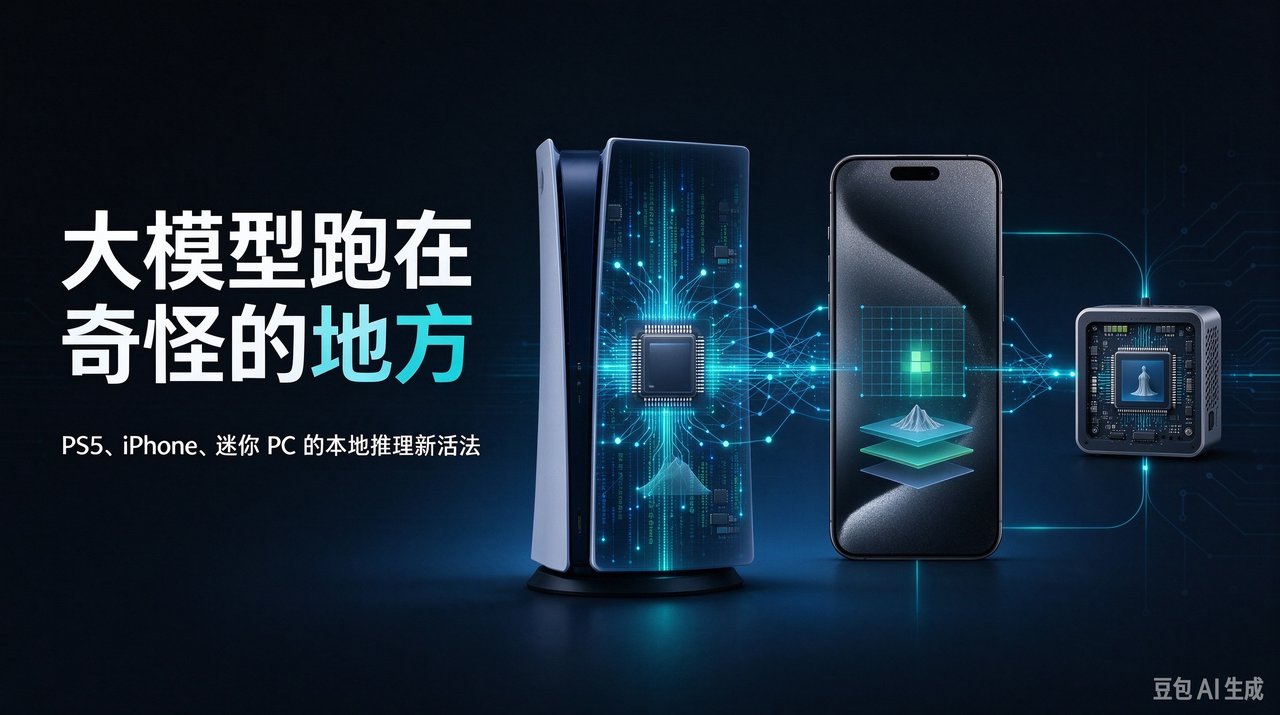
三个开源项目把大模型塞进了奇怪的地方:PS5 上跑 llama.cpp、iPhone 帮 Mac 跑 27B 模型、128GB 内存的迷你 PC 跑 300B MoE。本地推理的门槛,正在被硬件玩家一个个拆掉。
大模型跑在奇怪的地方:PS5、iPhone、迷你 PC 的本地推理新活法
本地跑大模型,标配是"高配显卡 + 大内存"——这是刻板印象。最近几个开源项目,正把大模型塞进你意想不到的地方:游戏主机、手机、迷你 PC。
第一站:PS5 上跑 llama.cpp
项目 PS5LM(GitHub 73 stars)做的事一句话:在破解的 PS5 上跑 llama.cpp,原生运行任何 GGUF 格式的模型,目前验证支持 Qwen 3.8。
对 PS5 用户来说,这台游戏机本身性能不弱(强 CPU + 16GB 统一内存),作为一台"闲置的本地推理机"完全够用——尤其适合手头有破解主机、又不想为本地模型单独配机器的玩家。
怎么用:跟着项目 README 在破解的 PS5 上装 llama.cpp,拷入 GGUF 模型文件,跑起来当本地聊天/推理服务器。
第二站:iPhone 帮 Mac 跑 27B 模型
项目 backburner(GitHub 926 stars,相当火了)的思路更妙:你的 iPhone 帮你的 Mac 跑一个 27B 模型——用一根 USB-C 线连起来,iPhone 负责推理,Mac 负责界面。好处是"更快的提示读取和更多上下文":iPhone 的硬件加速和统一内存,让原本 Mac 跑不动的 27B 模型变得可用。
对 Mac 用户来说,这等于不用升级 MacBook,用身边的 iPhone 白嫖一块"推理副卡"。你的旧 iPhone 不用躺在抽屉里吃灰,插上 USB-C 就能当 AI 算力。
怎么用:Mac 装 backburner,iPhone 装配套端,USB-C 一线连,跑本地模型。
第三站:128GB 内存的迷你 PC 跑 300B MoE
项目 Kyojin(GitHub 96 stars)是 Yamz Labs 为 AMD Strix Halo(ROCm, gfx1151) 构建的推理引擎,基于 ExLlamaV3。它的目标:在 128GB 统一内存的迷你 PC 上,跑 300B 级别的 MoE 模型。
这是最"正经"的一条——不是玩梗,是实打实的本地大模型硬件方案:AMD 新一代 APU 把大内存和强核显焊在一起,迷你 PC 的体积、游戏本的功耗,能跑出以前要服务器才带得动的模型。对数据不出门、要本地跑大模型的个人/小团队,这是一条很值得关注的路。
怎么用:买一台 Strix Halo 的迷你 PC(128GB 版),装 Kyojin 推理引擎,加载 300B 级 MoE 模型。
信号强度
这三件事拼在一起,指向同一个趋势:本地推理的门槛正在被硬件玩家一个个拆掉。以前"本地跑大模型"意味着攒一台几万块的机器,现在——闲置的 PS5 能跑、抽屉里的 iPhone 能当算力、迷你 PC 能顶服务器。背后的共同变量是统一内存架构(PS5、iPhone、Strix Halo 都是 CPU/GPU 共享内存),它让"不用显存也能跑大模型"从不可能变成可能。
对普通用户:本地推理最大的价值是隐私和免费——数据不出门、不按 token 计费。如果你的旧游戏机、旧手机、或者想添置的迷你 PC 能顶上,本地模型就不只是折腾党的玩具了。对想布局本地 AI 的人来说,先别急着上服务器,看看手边有什么能变成算力。
PS5LM:https://github.com/cobanov/PS5LM
backburner:https://github.com/StayLameBro/backburner
原载:GitHub
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://github.com/cobanov/PS5LM(GitHub)