OpenClaw 2.0 实测:把 Agent 从“能干活的工具”做成“能托管的系统”
雷峰网用 1.x 与 2.0 跑同一道复杂长任务实测:2.0 的 LLM 请求次数降 38%、全程不触发上下文压缩,把 Agent 从"能干活的工具"往"能长期托管任务的系统"推了一步,但安装门槛依然没打掉。
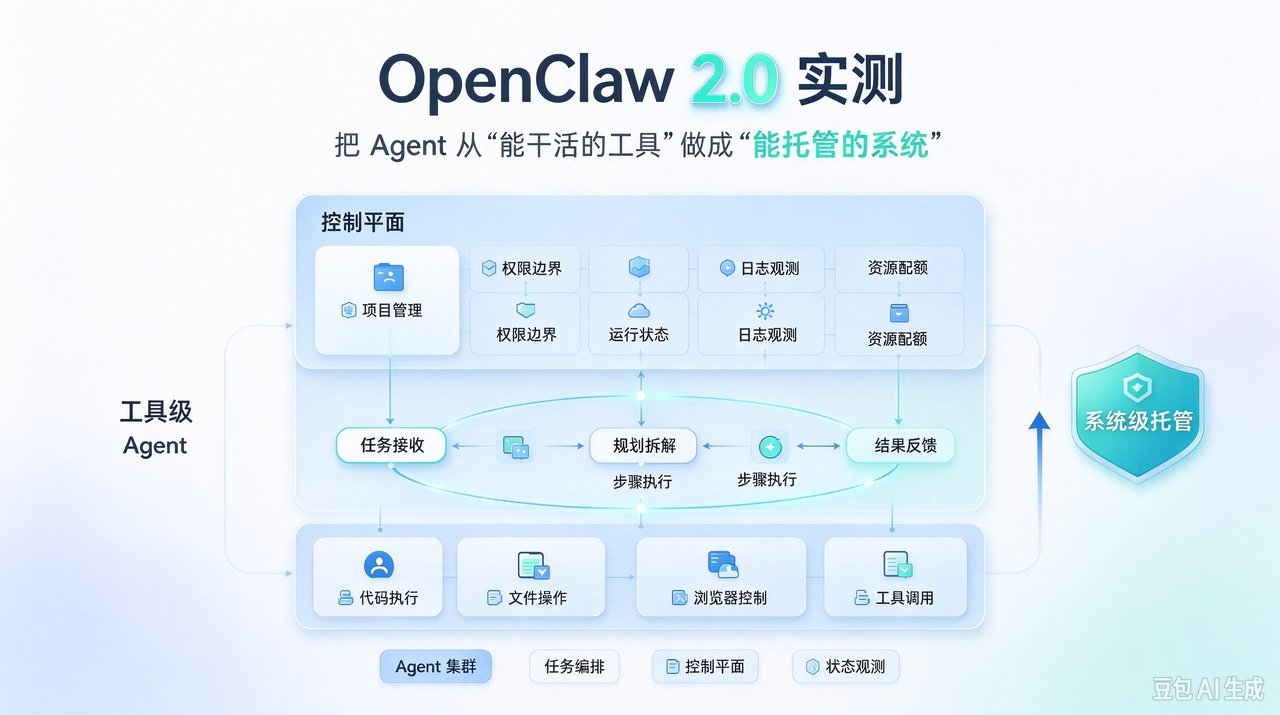
OpenClaw 2.0 实测:把 Agent 从“能干活的工具”做成“能托管的系统”
你手上已经有不少能"干一单"的 Agent:给它一个任务,它跑完给你一份交付。但当你开始指望它长期在线、跨天干活、跑完还能复盘时,大多数 Agent 就露馅了——上下文一长就压缩、一压缩就丢细节、一丢细节就得人肉盯着补。
8 月 31 日发布的 OpenClaw 2.0(v2026.8.1)想解决的正是这个。它有 933 位贡献者、16,962 个 PR 提交,过去 230 天发了 106 个版本——但它不是简单给 Agent 多补几个工具,而是把安装、浏览器、云会话、记忆管理、插件、安全、多人协作和恢复能力几乎重新梳理了一遍。雷峰网拿 1.x 和 2.0 在同一台服务器上跑了同一道复杂长任务做对比,数据比口号更有说服力。
两版实测:慢没慢,但"步子"变了
测试任务是一条完整的打工人工作流:调研 OpenClaw 2.0 的公开信息 → 区分一手/二手/无法确认 → 整理成向领导汇报的材料 → 做成可视化网页。两个版本都跑完了,但执行方式完全不同:
- LLM 请求次数:74 → 46,降 38%
- 工具调用结果:100 → 65,降 35%
- 单次请求输入 token:约 4,990 → 11,237,涨到 2.25 倍
1.x 是"小步多轮"——频繁来回切换工具、问模型;2.0 是"大步少轮"——每次请求带更多上下文、做更重的判断。总耗时基本持平(103.3 分钟 vs 106.1 分钟),但 2.0 的碎片化决策和丢上下文风险明显更低。
最硬的数据是上下文压缩:1.x 在任务中触发了一次 138,781 tokens 的压缩(早期细节被摘要替代,存在信息损失),而 2.0 全程没有触发压缩,却交出了更长的报告和更完整的网页。这与 2.0 主推的状态工程、SQLite 存储和上下文管理方向吻合。
2.0 到底改了什么
界面和交付方式的变化最直观:1.x 像一个"把底层配置摊给用户的工程控制台",2.0 则像 Codex、Claude Code 一样把任务拆成多个步骤——前提校验、官方信源调研、社区与媒体调研、竞品梳理、报告生成、可视化验证——每一步直接写出产物路径和验证方式,用户可以沿着清单复查资料、网页和原始记录。
一句话:1.x 是研究员交全量资料包,2.0 是给管理者看的判断材料。
怎么用:它适合谁
2.0 的安装仍走命令行——macOS/Linux 一条脚本命令,Windows 用 PowerShell,普通用户需要理解终端、Node、安装脚本、端口和权限;对比 ChatGPT、Claude Code 这类成熟交互产品,它的网页界面也不算最讨喜的。但它真正站得住的,是这些系统能力:自托管、模型中立、多入口连接(消息工具/浏览器/终端/远端机器)、长期会话、记忆管理、团队协作。所以它适合的不是“想要个更好用的聊天助手”的人,而是这类场景:
- 媒体调研 / 投研分析 / 产品研究:需要长时间检索、整理、交付、复盘的工作流,跑完能沿着产物清单复查每一份信源
- 技术管理 / 小团队协作:把 Agent 接进团队的消息渠道,共享会话和凭证
- 对数据主权敏感的人:自托管意味着上下文和记忆都在自己的机器上
信号强度
OpenClaw 2.0 的进步是真实的:它没有把任务跑得更快,但让长任务更少被打断、更少依赖人工催促、更容易被复盘。从后台数据看,这不是换了一层界面,而是真的在用更集中的方式处理长任务。
但它不是一个“更好用的助手”,而是一个面向复杂工作流的 Agent 基础设施——值得放进受控环境里认真测,尤其适合媒体调研、投研分析、产品研究这类需要长期检索、整理、交付和复盘的工作流。
项目主页:https://github.com/openclaw/openclaw
原文:https://www.leiphone.com/category/yanxishe/7bPyLlZDfncTOw5B.html
原载:雷峰网
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://www.leiphone.com/category/yanxishe/7bPyLlZDfncTOw5B.html(雷峰网)