Hindsight:让 Agent 学会“记得你”——LongMemEval 第一的记忆系统,Docker 一条命令就能跑
Agent 记忆一直是老大难:RAG 检索丢上下文,知识图谱建起来太费劲。Hindsight 用向量库 + 对话历史的做法,在 LongMemEval 基准拿下第一,核心只有 retain(存)和 recall(找)两个 API,Docker 一条命令起服务,客服、项目助手这类要“长期服务同一批人”的场景正合适。
Hindsight:让 Agent 学会“记得你”——LongMemEval 第一的记忆系统,Docker 一条命令就能跑
情报来源:逛逛GitHub《盘点 20 个 9 月份 GitHub 上顶顶顶的开源项目》(2026-10-11)· 项目地址 github.com/vectorize-io/hindsight · 用法与基准数据对照 README 核对
一文看懂
先看痛点。 Agent 的“失忆”是行业级痛点:客服 Agent 记不住你上次说过什么,每次都要你重复背景;项目 Agent 干完活就忘了项目为什么这么设计。主流解法里,RAG 检索容易丢上下文、答非所问,知识图谱建起来费时费力维护成本高。市面上缺一个“真的会记、还记得住”的方案。
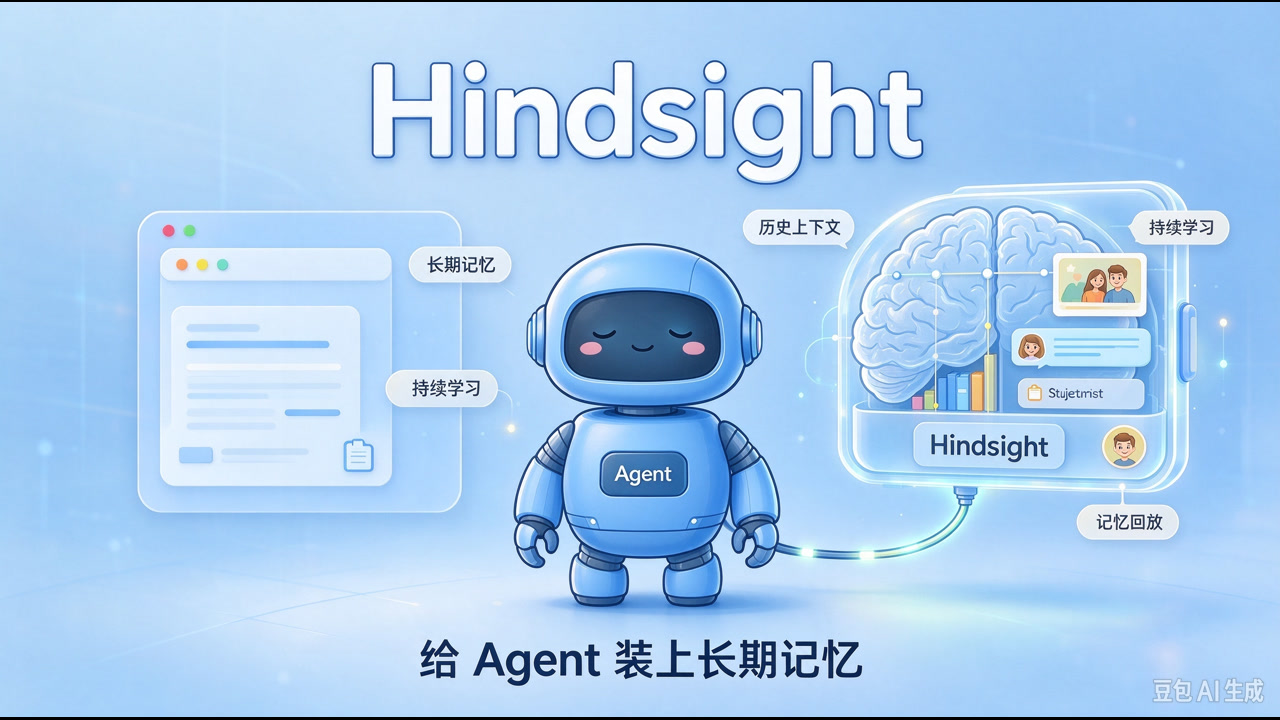
主角登场。 Hindsight(vectorize-io/hindsight)是 Vectorize 开源的 Agent 记忆系统,定位一句话:让 Agent 学习,而不只是记住。它在 LongMemEval(评估记忆系统的行业基准)上拿了目前第一。核心 API 只有两个——retain(存)和 recall(找),Docker 一条命令起服务,几分钟就能给现有 Agent 接上长期记忆。
核心机制:不存“对话记录”,存“可检索的事实”
多数记忆系统的问题在于只回放对话历史:聊到哪存到哪,找的时候一锅端。Hindsight 的做法是按内容组织:retain 时把信息存进一个“记忆库”(bank),recall 时用自然语言查询精确找回来——找的是“事实”,不是“聊天记录”。
最简用法(Python):
from hindsight_client import Hindsight
client = Hindsight(base_url="http://localhost:8888")

# 存:告诉它 Alice 是谷歌软件工程师
client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")

# 找:问"Alice 是做什么的?"
client.recall(bank_id="my-bank", query="What does Alice do?")
bank_id 是关键设计:按用户、按项目各建一个记忆空间,互不串味——客服系统给每个客户一个 bank,项目 Agent 给每个项目一个 bank。这是它和“全局一锅记忆”的本质区别,也是它能在真实业务里用的原因。
部署:Docker 一条命令
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  ghcr.io/vectorize-io/hindsight
服务起来后,Python / Node.js / Go / CLI 四个客户端任选接入。不想自托管也有托管版 Hindsight Cloud(按用量计费、送免费额度)。K8s 用户有官方 Helm chart。
基准:LongMemEval 当前第一
项目声称是“目前测过最准的 Agent 记忆系统”,依据是 LongMemEval 基准的当前成绩,而且实时结果公开(benchmarks.hindsight.vectorize.io),按模型、时延、成本分开列——不是拍脑袋自封,是能随时查证的榜。这一点对选型很关键:记忆系统最怕“装的时候感觉聪明,用起来全是幻觉”。
客户端不止 Python
除了 Python,官方还提供 Node.js / TypeScript(npm install @vectorize-io/hindsight-client)、Go(go get github.com/vectorize-io/hindsight/...)和 CLI(curl -fsSL https://hindsight.vectorize.io/get-cli | bash)——不管你的 Agent 栈是什么语言,记忆服务都能接上,这也符合它“记忆后端”的定位:跟框架解耦,谁都能用。
适合谁用
- 客服 Agent:保存用户历史沟通,下次直接接上背景,用户不用重复解释——README 点名的场景;
- 项目助手:回顾积累的记录,分析项目风险、决策依据,不因会话关闭而失忆;
- 任何“长期服务同一批人”的 Agent:只要你能定义出 bank 的粒度(按用户/按项目),Hindsight 就能当它的记忆后端。
注意它的定位:记忆服务(存 + 找),不是聊天框架——它给现有 Agent 提供记忆能力,不取代你的 Agent 本体。
信号强度
记忆是 Agent 从“工具”走向“同事”的分水岭:没有记忆的 Agent 每次都是新人,有记忆的 Agent 才谈得上累积和进化。Hindsight 的意义在于把“长期记忆”做成了一件标准化的基础设施——一个服务、两个 API、一个 Docker 命令,而不是每个团队自己造轮子。对正在给 Agent 做记忆层的团队,它值得跑一遍基准实测;LongMemEval 榜上见真章。
逛逛GitHub《盘点 20 个 9 月份 GitHub 上顶顶顶的开源项目》(2026-10-11)+ vectorize-io/hindsight README 核对
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://github.com/vectorize-io/hindsight(GitHub)