Claude 组队查 Bug 比单干强三倍?66 对 27 背后的多 Agent 编排真相
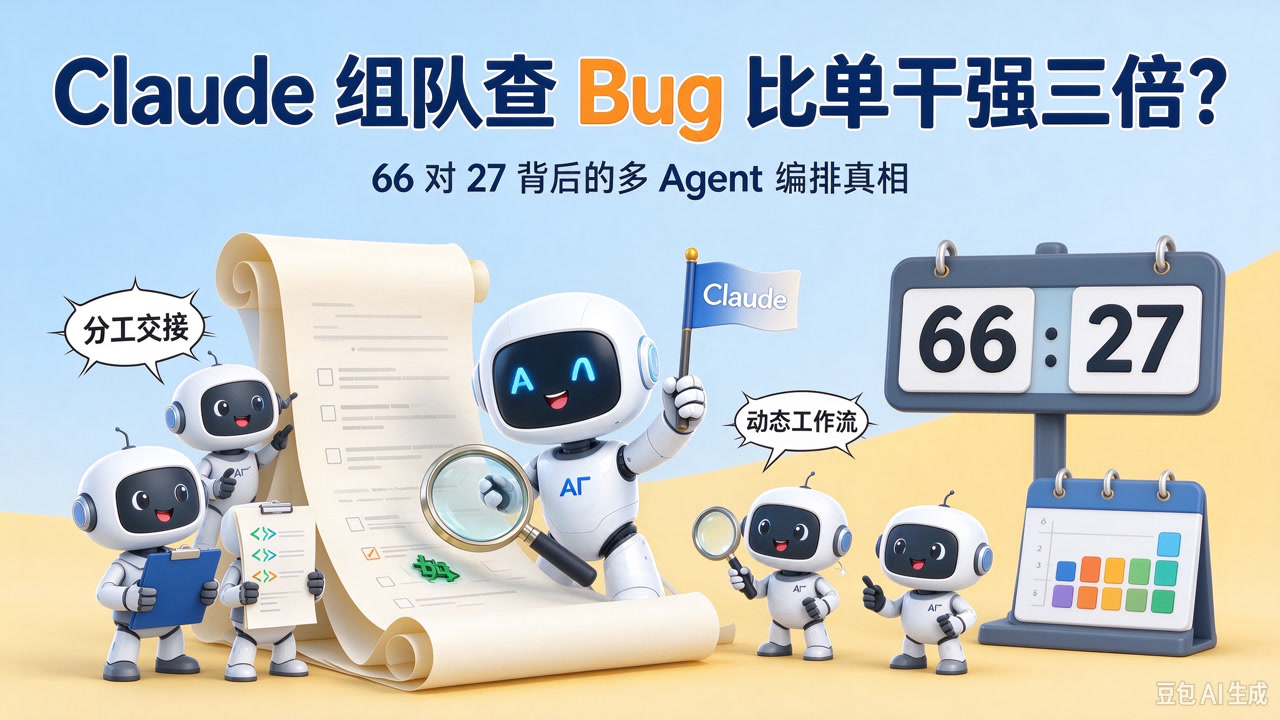
Anthropic 让 Claude 自己组队:11.6 万行代码埋 70 个 Bug,单 Agent 三次最好找出 27 个,换成动态工作流连跑三次都是 66 个。背后是 Claude Managed Agents 动态工作流开启公测——主 Agent 把分工写进程序,调度最多 1000 个子 Agent 分阶段干活。多 Agent 协作从“人当传话员”走向“程序化编排”,但成本账还没算清。
Claude 组队查 Bug 比单干强三倍?66 对 27 背后的多 Agent 编排真相
情报来源:新智元《Claude自己组队查Bug!11.6万行代码揪出66个,单Agent最高只找到27个》(2026-10-11)· 事实核对:The Decoder(2026-10-12)· Anthropic 官方数据
一文看懂
先看痛点。 同时开几个 AI 窗口干活不难,难的是“给每个窗口重讲一遍背景、把一边的发现搬到另一边、再挨个追问做到哪了卡在哪”——窗口越多,人越像传话员。多 Agent 协作喊了好几年,真正的瓶颈从来不是“能不能开很多 Agent”,而是谁来分工、谁盯进度、谁把结果拼起来。
Claude 开始自己接管这些事了。 Anthropic 公布了一组测试:在 11.6 万行代码里预埋 70 个 Bug,让单 Agent 和动态工作流各跑三次。结果——单打独斗三次分别找出 14、15、27 个(最好也没到四成);换成 Claude 自己组队,三次全是 66 个,九成以上。背后是两个新东西:Claude Managed Agents 动态工作流(主 Agent 写“分工程序”,调度子 Agent 分阶段干活)和 Claude Code Projects 扩大公测(围绕一个项目持续对话,Claude 拆任务、协调多条线程并行)。
66 对 27:先看清这是什么测试
先说清边界,别被“三倍”冲昏头:
- 数据来自 Anthropic 自己公布的实验,埋的是“好找”的 Bug 还是“刁钻”的 Bug、代码是什么项目,官方没披露——这是自家产品宣传,不是第三方评测;
- 文章也承认:官方没公布所用模型、实际 Agent 数量、耗时、Token 用量和误报情况——“多找出 Bug”是真的,但“更快更划算”还没账;
- The Decoder 引用了一位 OpenAI 高级工程师的吐槽:Agent 蜂群是“巨大的 token 浪费”。观点存疑,但点出了一个真问题——多 Agent 多花多少成本,才是组队值不值的关键。
所以 66 对 27 的准确读法应该是:在“团队协作 vs 单干”的对比上,协作方向对了;具体值不值得,得拿自己的活去测。
动态工作流:分工被写进了程序
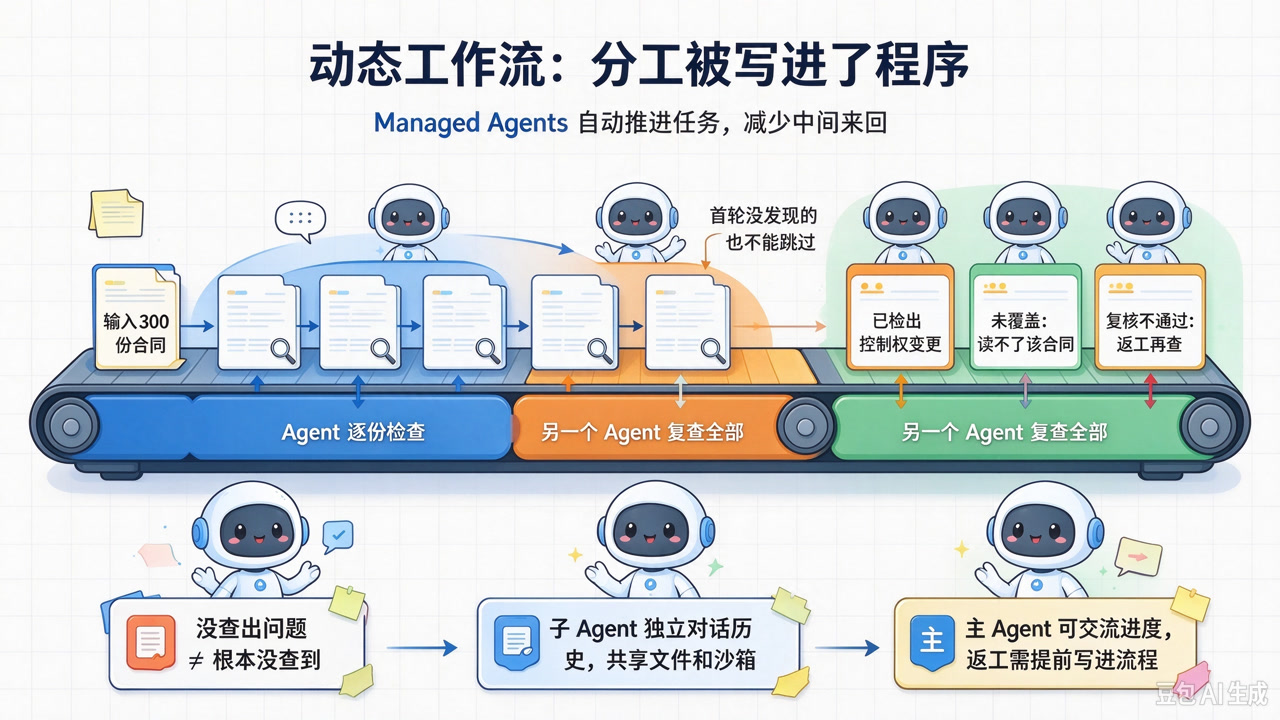
Managed Agents 动态工作流(公测:美西 10-09 = 北京 10-10)解决的就是“分工交接”这个老大难。以前的子 Agent 委派是“主 Agent 读汇报 → 想下一步 → 再指挥”,中间全是来回;动态工作流把大量中间交接写进程序,在后台自动推进。
官方给的例子:检查 300 份合同,找出含“控制权变更”条款的。Claude 会写一段工作流程序:第一轮每份合同派一个 Agent;第二轮让另一个 Agent 复查全部(首轮没发现的也不能跳过);复核不通过的返工再查。
几个值得记的设计:
- “没查出问题”和“根本没查到”必须分开——某个 Agent 读不了某份合同,就把这份标成“未覆盖”,其余任务继续。这招防止“一份整齐的汇总把缺口藏起来”,是整套机制里最值得抄的一点;
- 子 Agent 各有独立对话历史,共享文件和沙箱——上下文隔离,但工作环境共享;
- 主 Agent 运行期间仍能和你交流、看进度,但要返工得提前写进流程——工作流跑起来后,不能像普通子 Agent 那样中途追问某个线程。
规模数字:单次运行累计最多 1000 个 Agent,当前文档写的并发上限 64 线程(官方说明可能调整)。接入方式:API 里把 multiagent 配置的 type 设为 multiagent_20261001;用 Claude Code 的话,跑 /claude-api managed-agents-onboard 快速上手。
Projects:给 Agent 装“项目记忆”
和动态工作流同一天,Claude Code Projects 也扩大了公测范围(此前 9-17 已分批公测,这次等待名单的 Pro/Max 用户基本都进了)。
Projects 解决的是另一个问题:跨任务记得住。你在同一个项目对话里持续提需求,Claude 判断该新开线程还是交给已有线程;每条线程是独立推进的工作对话,有自己的上下文和代码副本,在自己的分支上干活,再把结果报回项目对话。项目总览把“正在工作 / 等你回答 / 可以审查”分开列,离开半天回来不用挨个问进度。
它还攒项目记忆:需求改了什么、做过什么决定、哪个服务改前要找谁确认,都能记下来供后续线程读。官方例子很生活化——“发布日期改到周五”“某项功能为什么被砍”——这些都能留在记忆里。云端线程合上电脑继续跑;要用本机工具或本地数据库的任务走 Remote Control,但电脑得保持唤醒。
哪些活值得组队:一个判断框架
从 66 对 27 的实验反推,适合动态工作流的任务有三个特征:①可拆分——能切成多个独立子任务(查不同文件、读不同合同),子任务之间耦合小;②有边界——任务存在“没查到”和“查不到”的区分(查 Bug 是典型:没发现 ≠ 没查,缺口必须单独标注);③结果可自动验收——能把检查写进流程(第二轮复查、返工循环),不需要人反复介入。
反过来,强依赖全局上下文连贯的任务(比如“顺着这个设计思想把整个架构改完”),拆给 1000 个 Agent 只会各说各话,反而不如单干。多 Agent 不是放大镜,是流水线——它放大的是“可并行、可验收”的那类活,不是所有活。
怎么用:摸清消耗再上复杂度
费用要分开算:
- Projects:用现有套餐额度,线程和协调对话都消耗用量,并行越多烧得越快;线程达到上限会暂停,等额度重置;
- Managed Agents:按模型 Token 计费 + 每个会话每小时 0.08 美元运行费(只算运行状态时长),Token 另算;可设会话预算,但达到预算时已发出的模型请求仍会完成,最终可能超预算。
所以官方自己也建议:先从范围明确的小任务开始,摸清消耗,再逐步加复杂度。这套编排的本质是“用更多模型调用换更少人工协调”,你的场景里这两者哪个更贵,只有自己测过才知道。
信号强度
66 对 27 最大的价值,不在那个数字,在于它标志着多 Agent 协作从“人肉指挥”跨进了“程序化编排”:分工、交接、返工、缺口标注都变成了代码,人可以只给目标、预算和验收标准。这对我们做 Agent Collab 这类协作台的人尤其值得抄——特别是“未覆盖列表”和“提前把返工写进流程”这两个设计,直接解决多 Agent 系统里最脏的两个问题:缺口被吞、返工无人认领。至于“组队到底省不省钱”,OpenAI 那句吐槽和 Anthropic 的测试各自代表一边,答案不在任何人的宣传里,在你自己的账单里。
新智元《Claude自己组队查Bug!11.6万行代码揪出66个,单Agent最高只找到27个》(2026-10-11)+ The Decoder 实测核对(2026-10-12)
本文基于 AI 情报库收录的条目展开深析;事实性信息以原始报道为准,分析与展望为编辑观点。
原始报道:https://the-decoder.com/anthropics-claude-can-now-orchestrate-up-to-1000-ai-agents-in-parallel-through-dynamic-workflows/(The Decoder)